Posts
Sua IA respondeu errado mesmo com a informação salva? Faça o Teste do Arquivo Certo
O estudo WorkWorlds: An Infrastructure for Evaluating AI Agents on Workplace Tasks, publicado inicialmente em setembro de 2026, investigou como agentes de IA executam tarefas quando precisam encontrar informações em ambientes de trabalho.
Você usa IA todos os dias. Mas ela está realmente dando resultado?
Usar mais inteligência artificial não significa necessariamente trabalhar melhor. A diferença aparece quando você mede o que acontecia antes da IA e o que acontece depois dela.
A transcrição parece perfeita.
O avanço da IA por voz está tornando reuniões, mensagens e comandos cada vez mais fáceis de automatizar. Mas um benchmark recente expõe um problema importante: uma transcrição pode parecer excelente e ainda errar justamente a informação que dispara a próxima ação.
Exibir depoimentos reais
Compartilhar grandes novidades
Seus clientes estão delirando com você nas mídias sociais? Compartilhe as melhores histórias para ajudar a transformar possíveis clientes em clientes fiéis.
Promover ofertas atuais
Compartilhar grandes novidades
Compartilhar grandes novidades
Você está fazendo uma liquidação de final de ano ou uma promoção semanal especial? Anuncie aqui para atrair clientes que estejam atrás de uma boa oferta.
Compartilhar grandes novidades
Compartilhar grandes novidades
Compartilhar grandes novidades
Você abriu uma nova loja, reformou seu local ou adicionou um novo produto ou serviço? Não guarde para si. Conte para todos.
Exibir as perguntas frequentes
Exibir as perguntas frequentes
Exibir as perguntas frequentes
Os clientes têm perguntas, você tem as respostas. Mostre as perguntas mais frequentes para que todos saiam ganhando.
Sua IA respondeu errado mesmo com a informação salva?
Informações adicionais
Você pediu uma informação para a IA. Ela respondeu com segurança. Só que a resposta estava errada — e o documento correto existia.
É tentador concluir que a IA não é inteligente o suficiente.
Mas existe outra possibilidade: ela não encontrou a informação necessária para responder.
Esse problema aparece quando usamos inteligência artificial para consultar contratos, propostas, relatórios, atas de reunião, planilhas e arquivos de projetos.
E uma pesquisa recente ajuda a explicar por quê.
O que a pesquisa descobriu
O estudo WorkWorlds: An Infrastructure for Evaluating AI Agents on Workplace Tasks, publicado inicialmente em setembro de 2026, investigou como agentes de IA executam tarefas quando precisam encontrar informações em ambientes de trabalho.
Os pesquisadores compararam duas situações:
Situação A: a IA recebe acesso ao conjunto completo de arquivos e registros disponíveis para determinado funcionário.
Situação B: a IA recebe um conjunto menor de arquivos relevantes para a tarefa, selecionados previamente.
Foram realizadas 192 execuções, distribuídas por oito tarefas de uma empresa farmacêutica sintética.
O estudo também observou que, quando os agentes efetivamente acessavam evidências suficientes, as taxas de aprovação eram semelhantes.
A interpretação mais importante é esta:
Uma parte relevante da dificuldade apareceu antes da resposta, durante a busca e a localização das informações.
Isso não significa que todos os agentes apresentem esses resultados. O estudo utilizou tarefas específicas e um ambiente experimental. Também não demonstra que fornecer menos arquivos sempre melhora o desempenho.
Mas revela um problema que qualquer profissional pode investigar no próprio trabalho.
Por que isso importa no dia a dia?
Imagine três situações.
Situação 1 — O prazo errado
Você pergunta:
“Qual é a data de entrega aprovada para o projeto?”
A IA encontra um cronograma antigo e responde com a data anterior.
O documento atualizado existe, mas não foi consultado.
O problema não foi uma conta errada.
Foi usar a fonte errada.
Situação 2 — A proposta desatualizada
Você pergunta:
“Qual foi o valor final aprovado pelo cliente?”
A IA encontra a proposta original, mas não localiza a revisão que mudou o orçamento.
A resposta parece plausível.
Só que está desatualizada.
Situação 3 — A decisão que ficou perdida
Você pergunta:
“O que ficou decidido na última reunião?”
A IA resume uma ata antiga, mas deixa de considerar a reunião mais recente.
O resultado pode ser um plano de ação baseado em decisões que já foram substituídas.
Nos três casos, pedir uma resposta mais detalhada não resolve necessariamente o problema.
Primeiro é preciso descobrir quais documentos foram encontrados, quais versões foram utilizadas e quais evidências sustentam a resposta.
O método GearIA: Teste do Arquivo Certo
O objetivo é descobrir se sua IA consegue encontrar, selecionar e usar informações confiáveis antes de responder.
Você não precisa criar um sistema complexo.
Pode começar com uma pasta de arquivos de teste e algumas perguntas.
Etapa 1 — Escolha uma tarefa real
Selecione algo que você ou sua equipe fazem frequentemente.
Por exemplo:
- descobrir o prazo atualizado de um projeto;
- localizar uma decisão de reunião;
- comparar a versão atual e a anterior de uma proposta;
- identificar o valor aprovado de um orçamento;
- encontrar uma cláusula em documentos autorizados.
Prefira uma tarefa cuja resposta correta você já conheça e consiga verificar.
Isso é fundamental.
Sem uma resposta de referência, você não consegue medir o erro com segurança.
Etapa 2 — Prepare os arquivos
Monte um pequeno conjunto de documentos de teste.
Exemplo fictício:
Arquivo 1: Cronograma_Projeto_v1.docx
Data de entrega: 15/10/2026.
Arquivo 2: Ata_Reuniao_02-10-2026.docx
Registra uma proposta de alteração para 22/10/2026.
Arquivo 3: Cronograma_Aprovado_03-10-2026.xlsx
Confirma a data final aprovada: 24/10/2026.
A resposta esperada é 24/10/2026, com referência ao cronograma aprovado.
Atenção: esses são dados fictícios para demonstração.
Etapa 3 — Faça o teste sem indicar o arquivo certo
Se sua ferramenta de IA possui acesso autorizado e capacidade de pesquisar os arquivos, inicie uma conversa nova.
Use:
PROMPT 01 — BUSCA
“Localize a data de entrega final aprovada para o Projeto Exemplo. Pesquise somente os arquivos aos quais você tem acesso autorizado. Identifique os documentos relevantes, suas datas e versões. Não considere uma proposta de alteração como aprovação definitiva. Informe a data final somente se encontrar evidência suficiente. Cite o nome do documento e o trecho que sustenta sua conclusão. Caso não encontre a informação, diga explicitamente que não foi possível confirmar.”
Registre o resultado.
A IA encontrou o cronograma aprovado?
Usou a versão mais recente?
Conseguiu citar o documento?
Respondeu corretamente?
Se a ferramenta não tiver capacidade de pesquisar arquivos, não trate isso como erro de raciocínio: o recurso de busca simplesmente não está disponível.
Etapa 4 — Repita com os documentos relevantes
Abra uma nova conversa, com a mesma ferramenta e configurações.
Agora forneça os três documentos relevantes.
Repita exatamente a mesma pergunta.
O objetivo é comparar duas condições:
A — A IA precisa localizar as evidências.
B — As evidências são fornecidas diretamente.
Se o resultado melhora na condição B, isso sugere que a localização ou recuperação da informação merece investigação.
Mas não prova, sozinho, que a busca foi a única causa.
Para uma avaliação mais confiável, repita o teste em várias tarefas.
Etapa 5 — Exija evidências
Independentemente do resultado, faça uma segunda solicitação.
PROMPT 02 — CONFERÊNCIA
“Revise sua resposta e apresente uma tabela com: afirmação, documento utilizado, data ou versão do documento, trecho de evidência e grau de confirmação. Separe fatos comprovados de inferências. Se houver documentos conflitantes, mostre o conflito antes de concluir. Não invente citações ou referências.”
Confira manualmente os documentos citados.
Uma citação produzida pela IA não é garantia de que o documento realmente sustenta a afirmação.
Etapa 6 — Identifique onde ocorreu a falha
Se a resposta estiver incorreta, use:
PROMPT 03 — DIAGNÓSTICO
“Compare sua resposta com os documentos de referência que forneci. Identifique se o erro ocorreu por: (1) documento não encontrado, (2) versão incorreta, (3) evidência encontrada mas interpretada incorretamente, (4) conclusão não sustentada pelas fontes ou (5) informação insuficiente. Apresente as evidências para sua classificação e indique o que não consegue determinar.”
Não aceite a classificação da própria IA sem conferência.
Ela pode errar também ao explicar por que errou.
O diagnóstico precisa ser sustentado pelo histórico da execução e pelos arquivos disponíveis.
A planilha de avaliação
Repita o teste com dez perguntas reais.
Para cada pergunta, registre:
CritérioPontuaçãoEncontrou o documento necessário?0 ou 1Identificou a versão correta?0 ou 1Apresentou evidência verificável?0 ou 1Respondeu corretamente?0 ou 1Reconheceu falta de informação quando necessário?0 ou 1
Cada pergunta pode receber até cinco pontos.
Dez perguntas representam um máximo de 50 pontos.
Compare as pontuações das duas condições.
Não use a pontuação como certificação de segurança ou precisão universal. Ela serve para acompanhar o desempenho nas tarefas que você realmente precisa executar.
Mais importante que a nota total é identificar qual critério falhou repetidamente.
Como interpretar os resultados
Caso 1 — A IA só acerta quando você fornece os arquivos
Possível gargalo: busca, recuperação, indexação, permissões ou excesso de informação irrelevante.
O que fazer:
- revisar o acesso autorizado aos documentos;
- melhorar nomes e organização;
- eliminar versões ambíguas;
- criar um índice de documentos;
- testar a qualidade da pesquisa da ferramenta.
Caso 2 — A IA encontra o documento, mas usa a versão errada
Possível gargalo: controle de versões.
O que fazer:
- identificar documentos aprovados;
- manter datas e responsáveis claros;
- arquivar versões substituídas;
- instruir a IA a comparar fontes conflitantes.
Caso 3 — A IA encontra tudo, mas interpreta errado
Possível gargalo: compreensão, raciocínio ou instrução.
O que fazer:
- pedir uma análise por etapas;
- exigir trechos de evidência;
- decompor perguntas complexas;
- revisar a interpretação humana e automaticamente.
Nesse cenário, melhorar o prompt ou testar outro modelo pode fazer sentido.
Caso 4 — A IA não tem acesso ao arquivo
Possível gargalo: integração ou permissão.
O que fazer:
- verificar quais fontes estão realmente conectadas;
- conferir se o sistema pesquisa o conteúdo, não apenas nomes;
- validar permissões por função;
- evitar ampliar acessos indiscriminadamente.
Dar acesso a mais arquivos não é necessariamente a solução.
A IA deve acessar apenas as informações necessárias e autorizadas para executar a tarefa.
Cinco regras para usar IA com arquivos de trabalho
1. Não confunda resposta convincente com resposta comprovada.
Um texto bem escrito pode estar baseado no documento errado.
2. Peça sempre a fonte e a versão.
Especialmente quando o assunto envolve prazos, valores, decisões ou compromissos.
3. Diferencie “não encontrei” de “não existe”.
São afirmações completamente diferentes.
4. Não deixe a IA preencher lacunas como se fossem fatos.
Se a evidência estiver ausente, a resposta correta pode ser reconhecer a incerteza.
5. Teste com situações reais antes de automatizar.
Um workflow que funciona em uma demonstração pode falhar quando encontra documentos antigos, nomes parecidos ou permissões diferentes.
O que a pesquisa não permite concluir
O WorkWorlds é um preprint de pesquisa, não uma auditoria universal de ferramentas comerciais.
O principal experimento utilizou oito tarefas em um ambiente farmacêutico sintético, com execuções repetidas e condições controladas.
Os resultados não permitem afirmar que todas as IAs falham em determinada porcentagem dos casos.
Também não permitem concluir que basta reduzir a quantidade de arquivos para melhorar qualquer resposta.
A pesquisa mostra algo mais específico e útil:
o ambiente de informação e a capacidade de encontrar evidências influenciam o desempenho observado de agentes em tarefas de trabalho.
Essa é uma hipótese operacional que vale testar em empresas e projetos reais.
A conclusão GearIA
Quando a IA responde errado, a reação imediata costuma ser:
“Preciso de um modelo melhor.”
Ou:
“Preciso escrever um prompt melhor.”
Às vezes, isso é verdade.
Mas antes de trocar de ferramenta, vale fazer outra pergunta:
“A IA realmente encontrou a informação necessária para executar essa tarefa?”
Porque não adianta uma resposta excelente baseada no arquivo errado.
E produtividade com IA não é apenas produzir respostas mais rapidamente.
É conseguir produzir resultados corretos, verificáveis e úteis para tomar decisões.
Comece pelo Teste do Arquivo Certo. Descubra onde está a falha antes de tentar corrigi-la.
Fonte primária: Hua, Y.; Lian, L. WorkWorlds: An Infrastructure for Evaluating AI Agents on Workplace Tasks. arXiv, versão 2, 23 de setembro de 2026.
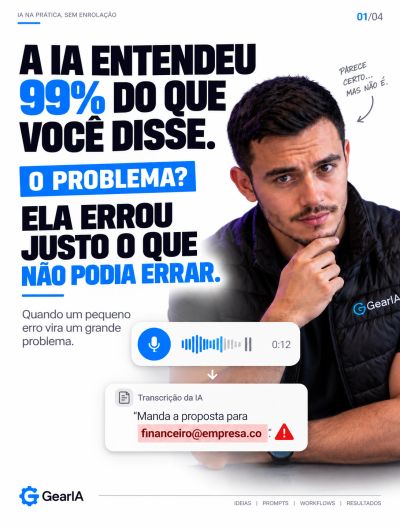
A transcrição parece perfeita,mas o dado crítico está errado
O avanço da IA por voz está tornando reuniões, mensagens e comandos cada vez mais fáceis de automatizar. Mas um benchmark recente expõe um problema importante: uma transcrição pode parecer excelente e ainda errar justamente a informação que dispara a próxima ação.
Imagine esta situação.
Você grava:
“Envie a proposta para financeiro@empresa.com.”
A IA entende perfeitamente a frase, reconhece a intenção e produz uma transcrição aparentemente impecável.
Só existe um problema.
Um caractere do endereço está errado.
Se o sistema estiver apenas produzindo texto, você provavelmente encontrará o erro durante a revisão.
Mas e se aquela transcrição estiver conectada a um agente que envia o e-mail automaticamente?
O problema deixa de ser qualidade de transcrição.
Passa a ser confiabilidade operacional.
E essa diferença será cada vez mais importante à medida que voz, agentes e automações começarem a fazer parte do mesmo workflow.
Um benchmark colocou esse problema à prova
O VoiceCodeBench foi desenvolvido para avaliar uma situação mais específica do que simplesmente descobrir se uma IA consegue transformar áudio em texto.
O benchmark reuniu 300 gravações de trabalho em inglês contendo informações que exigem precisão elevada.
Não apenas frases comuns, mas elementos como:
- URLs;
- comandos;
- caminhos de arquivos;
- identificadores;
- sequências específicas;
- outros dados cuja alteração de poucos caracteres pode modificar completamente o significado.
O resultado chama atenção.
Mesmo o sistema mais bem colocado no benchmark acertou todos os dados críticos em apenas 67,7% das gravações avaliadas.
Isso não significa que 32,3% de todas as palavras estavam erradas.
Essa distinção é fundamental.
Uma transcrição pode estar quase inteira correta e ainda falhar no critério que realmente interessa: preservar todas as informações críticas da gravação.
É justamente aí que aparece uma diferença importante entre avaliar IA como ferramenta de texto e avaliar IA como componente de um processo empresarial.
O problema não é apenas “transcrever corretamente”
Imagine duas transcrições.
Na primeira, uma IA troca “precisamos analisar isso amanhã” por “precisamos verificar isso amanhã”.
Existe uma diferença textual, mas provavelmente nenhuma consequência operacional relevante.
Agora imagine que a gravação contenha:
“Envie R$ 1.850 para a conta indicada.”
E a transcrição registre:
“Envie R$ 1.580 para a conta indicada.”
A quantidade de palavras corretas continua extremamente alta.
Mas a transcrição falhou exatamente onde não poderia falhar.
É por isso que métricas genéricas de precisão podem ser insuficientes para avaliar workflows reais.
A pergunta deixa de ser:
“A IA transcreveu corretamente?”
E passa a ser:
“Ela preservou corretamente todos os dados capazes de alterar a próxima ação?”
Essa é uma mudança pequena na pergunta — e enorme na maneira de estruturar uma automação.
A regra GearIA: avalie o dado pela consequência
Nem toda informação merece o mesmo nível de controle.
Uma palavra errada em um resumo interno pode exigir apenas uma correção.
Um número errado em uma cobrança pode gerar prejuízo.
Um e-mail incorreto pode provocar vazamento de informação.
Uma URL incorreta pode levar alguém para outro destino.
Um código errado pode fazer uma automação falhar.
Portanto, em vez de aplicar o mesmo nível de revisão a toda transcrição, uma abordagem mais eficiente é classificar as informações de acordo com a consequência de um erro.
Podemos dividir os dados em três níveis.
Nível 1 — Baixa consequência
Informações cujo erro não provoca uma ação relevante.
Exemplos:
- pequenas variações de redação;
- conectivos;
- repetições;
- linguagem informal;
- detalhes sem impacto na decisão.
Normalmente podem seguir sem confirmação específica.
Nível 2 — Consequência operacional
Informações capazes de alterar uma tarefa ou registro.
Exemplos:
- datas;
- horários;
- nomes;
- quantidades;
- responsáveis;
- números de pedidos;
- prazos.
Dependendo do workflow, vale destacar esses campos para revisão antes da execução.
Nível 3 — Alta consequência
Informações cujo erro pode provocar prejuízo, exposição de dados ou ação difícil de reverter.
Exemplos:
- endereços de e-mail;
- valores financeiros;
- dados bancários;
- URLs;
- credenciais;
- comandos;
- identificadores;
- endereços;
- parâmetros de sistemas.
Esses dados não deveriam ser tratados como texto comum.
Eles deveriam funcionar como campos críticos do workflow.
O Teste dos Campos Críticos
Antes de conectar voz diretamente a uma automação, a GearIA recomenda um teste simples com dados do próprio negócio.
O objetivo não é descobrir qual modelo vence um benchmark.
É descobrir se o seu processo está preparado para lidar com os erros que realmente importam.
Etapa 1 — Escolha um workflow real
Não faça o teste com frases artificiais.
Escolha algo que você realmente executa por voz.
Por exemplo:
- registrar pedidos;
- transformar reuniões em tarefas;
- criar compromissos;
- enviar informações para clientes;
- registrar dados no CRM;
- ditar comandos;
- preencher formulários;
- gerar propostas.
Etapa 2 — Separe 20 gravações
Use gravações representativas do ambiente real.
Inclua diferenças de:
- velocidade da fala;
- ruído;
- nomes próprios;
- números;
- sotaques;
- siglas;
- termos técnicos.
O objetivo não é facilitar o teste para a IA.
É reproduzir as condições nas quais ela realmente será utilizada.
Etapa 3 — Marque os campos críticos
Antes de processar os áudios, registre quais informações precisam estar exatamente corretas.
Exemplo:
“Agende com Mariana Lopes para terça-feira, 14h30, e envie a confirmação para mariana@empresa.com.”
Campos críticos:
- Mariana Lopes;
- terça-feira;
- 14h30;
- mariana@empresa.com.
Agora existe um critério objetivo.
Etapa 4 — Compare campo por campo
Depois da transcrição, não pergunte apenas se o texto ficou bom.
Monte uma tabela:
CampoOriginalTranscriçãoCorreto?ConsequênciaNomeMariana LopesMariana LopesSimMédiaDataterça-feiraterça-feiraSimAltaHorário14h3014h30SimAltaE-mailmariana@empresa.commarianna@empresa.comNãoAlta
Essa tabela revela algo que uma avaliação visual da transcrição pode esconder.
Etapa 5 — Crie regras diferentes para consequências diferentes
Depois dos 20 testes, classifique os campos.
Alguns poderão seguir automaticamente.
Outros deverão aparecer destacados para confirmação.
E determinadas ações poderão exigir aprovação humana obrigatória.
Por exemplo:
Transcrição → extração → classificação de risco → validação → execução.
Em vez de:
Transcrição → execução.
Essa pequena camada intermediária muda significativamente a arquitetura do workflow.
Não tente resolver tudo colocando um humano no meio
Existe uma conclusão tentadora:
“Então precisamos revisar todas as transcrições.”
Não necessariamente.
Isso pode eliminar boa parte do ganho de produtividade da automação.
A estratégia mais eficiente tende a ser revisão baseada em risco.
Se a IA está transformando uma reunião de 40 minutos em tópicos de discussão, talvez pequenas diferenças textuais sejam toleráveis.
Se está extraindo o endereço para onde um documento confidencial será enviado, a tolerância muda completamente.
A revisão deveria acompanhar a consequência.
Não simplesmente a existência da IA.
Outra alternativa: confirmação ativa
Em determinados workflows, o próprio sistema pode solicitar confirmação somente para os campos críticos.
Por exemplo:
“Entendi que você quer enviar a proposta para financeiro@empresa.com. Confirmar?”
Ou:
“Valor identificado: R$ 18.500. Confirmar antes de registrar?”
A automação continua rápida.
Mas existe uma barreira adicional exatamente onde um erro teria maior impacto.
Isso é diferente de obrigar uma pessoa a revisar toda a transcrição.
O que esse benchmark não prova
Também é importante não extrapolar os resultados.
O VoiceCodeBench avalia 300 gravações em inglês.
Isso significa que seus resultados não devem ser tratados automaticamente como taxa de erro para português brasileiro.
Desempenho pode variar conforme:
- idioma;
- sotaque;
- qualidade do microfone;
- ruído;
- vocabulário;
- domínio;
- modelo utilizado;
- contexto fornecido;
- tipo de dado.
Também não significa que ferramentas de voz sejam pouco confiáveis ou que não devam ser utilizadas.
A conclusão prática é outra:
benchmarks gerais não substituem testes de aceitação do workflow específico.
Se a automação da sua empresa depende de determinados dados, são esses dados que precisam ser testados.
O verdadeiro teste começa depois da transcrição
À medida que a IA por voz evolui, provavelmente veremos cada vez menos workflows terminando em uma simples caixa de texto.
A cadeia tende a ser:
voz → interpretação → decisão → ferramenta → ação.
E cada nova etapa aumenta a importância da anterior.
Quando o resultado final era uma transcrição para leitura humana, um erro podia ser encontrado antes de provocar alguma consequência.
Quando a transcrição alimenta diretamente uma automação, a mesma falha pode virar ação.
Por isso, uma métrica que parece técnica — precisão de transcrição — começa a se transformar em uma questão de arquitetura operacional.
O que fazer agora
Se você já utiliza voz, reuniões automáticas ou agentes que recebem instruções faladas, faça um teste antes de ampliar a automação.
Escolha um workflow.
Separe 20 gravações reais.
Identifique antecipadamente os campos críticos.
Compare esses campos individualmente.
Depois classifique cada tipo de dado de acordo com a consequência de um erro.
A partir daí, decida:
- o que pode seguir automaticamente;
- o que precisa aparecer para confirmação;
- o que exige aprovação humana;
- e quais ações não devem ser executadas diretamente a partir de uma transcrição.
A pergunta mais importante deixa de ser:
“Minha IA entende o que eu falo?”
A pergunta passa a ser:
“Quando ela entende algo errado, o que acontece depois?”
Essa é a diferença entre usar IA por voz e construir um workflow confiável com IA.
Fontes
VoiceCodeBench — Vals AI
Benchmark independente utilizado como principal evidência quantitativa deste artigo.
Nota metodológica: os resultados citados correspondem ao benchmark publicado e às condições específicas do teste. Não devem ser interpretados como taxa universal de precisão de sistemas de voz nem extrapolados automaticamente para português brasileiro.
Homem pensativo sobre erro da IA.